Det menneskelige udtryk
i en verden af AI
Danskudviklet detektion af AI-tekster og manipulerede billeder.
Mindre er mere. Mennesket mod maskinen.
Mennesker skriver med pauser, tøven og uforudsigelig rytme. Sprogmodeller udfylder tomrummet med kunstig symmetri, gentagne vendinger og mekanisk ensartet sætningsopbygning.
Sprogmodellens Maskinel
Sprogmodeller som ChatGPT, Claude og andre AI-modeller vælger ord efter sandsynlighedsfordelinger. På dansk resulterer det i lav sætningsvarians, forudsigelige overgange og standardiserede grammatiske vendinger.
- • Sætningsvarians under 3.5 ord (mekanisk ensartet)
- • Gentagne faste fraser og overgangsord
- • Billeder: Mangel på ægte kameradata og optisk mikrostøj
Det Menneskelige Udtryk
Menneskelige tekster udviser naturlig dynamik: korte sætninger efterfulgt af lange tankestrømme, uperfekte overgange og levede detaljer. På fotos bekræfter vi den fysiske kamerasensor, blændeværdi og optisk lysbrydning.
- • Høj burstiness: Organisk variation i sætningsopbygning
- • Naturligt talesprog og autentiske hverdagsformuleringer
- • Fysiske kamerasensor-signaturer (iPhone, Canon, Sony)
Billedforensik i praksis
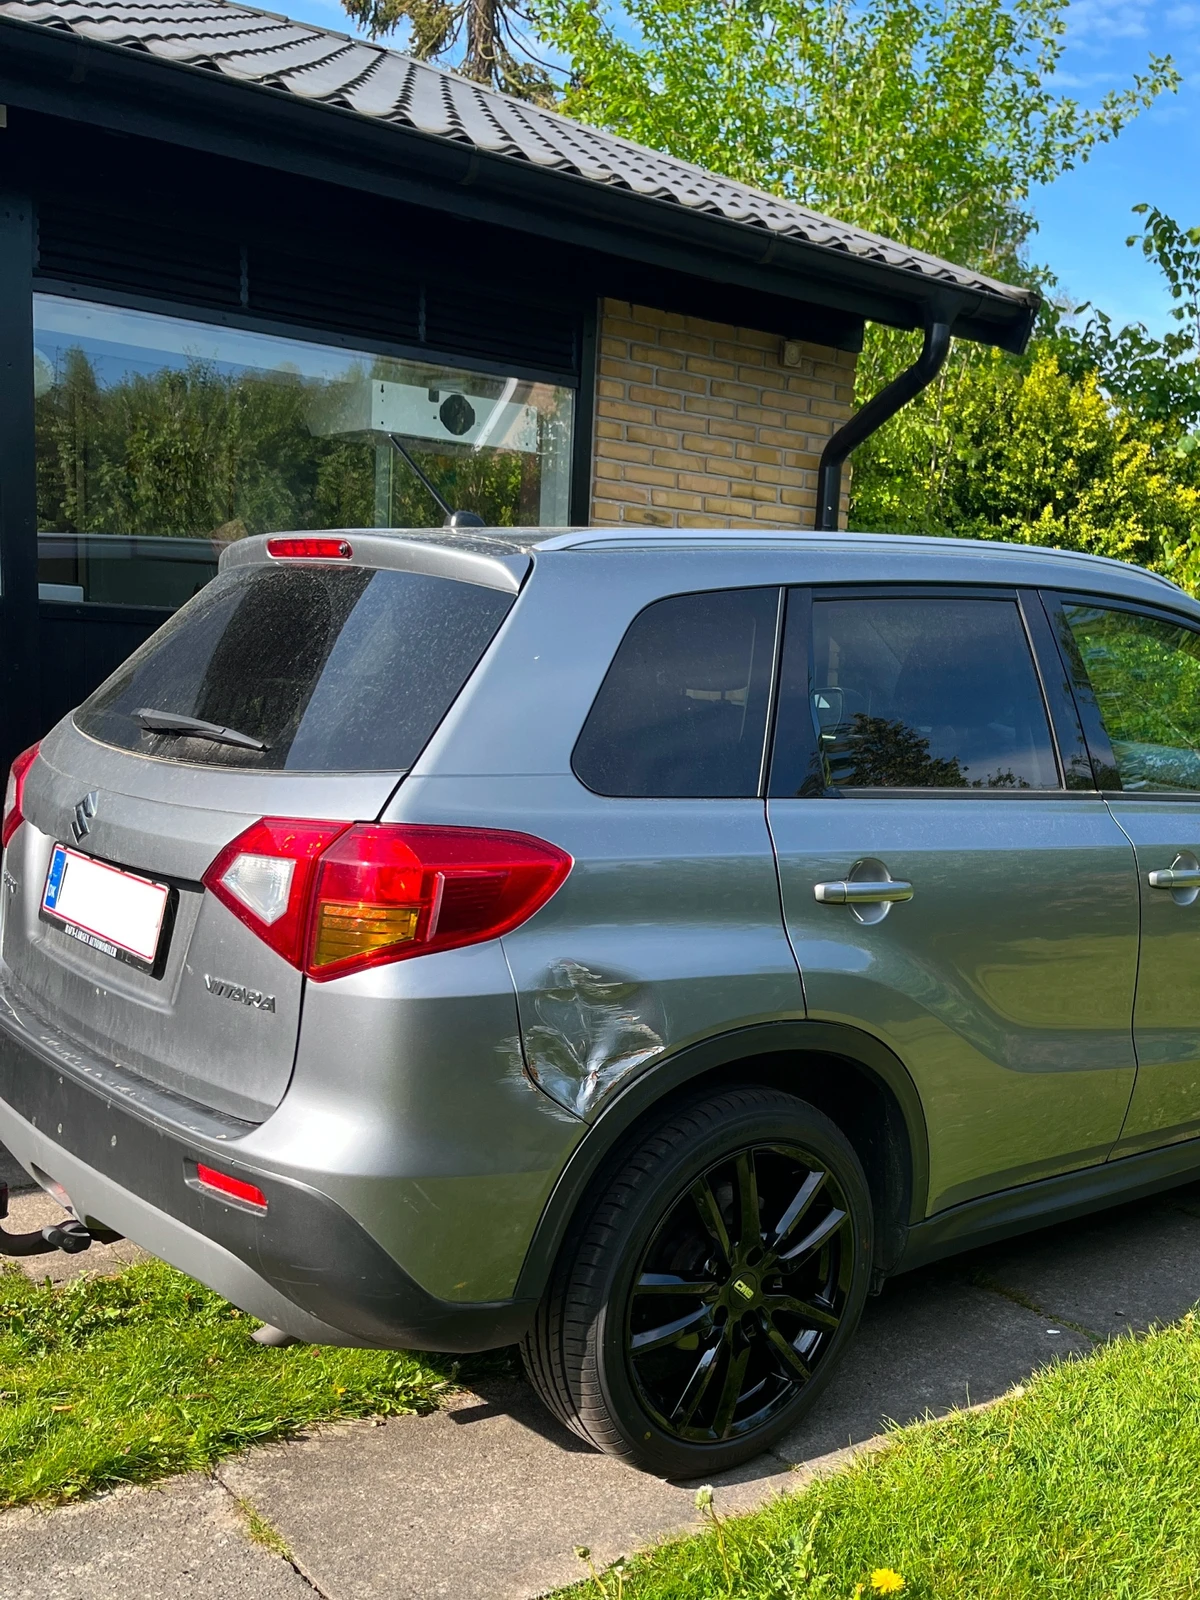
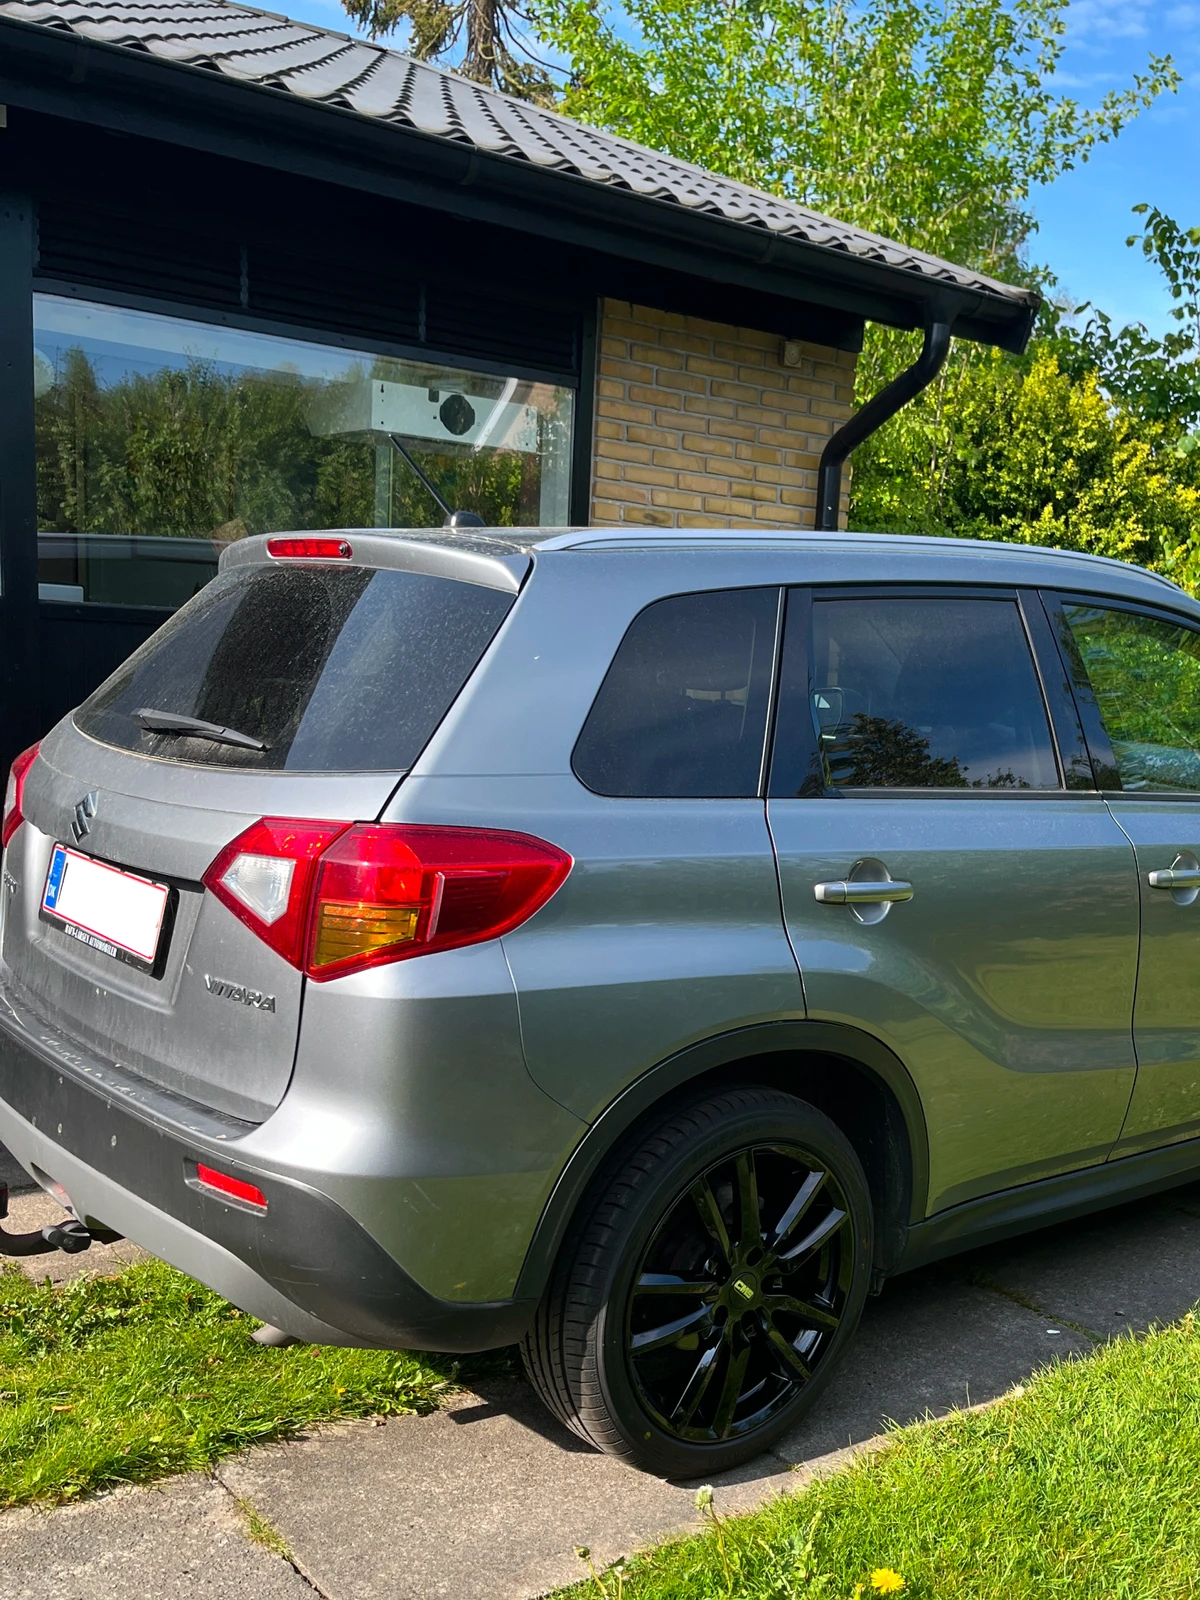
Træk i skyderen for at sammenligne originalt bilfoto med AI-tilføjede skader og ridser.
Sensorstøj & PRNU-konsistens
Hver fysisk kamerasensor afsætter et unikt mikroskopisk støjmønster i lyset. Ved AI-inmaling brydes denne sensorstøj i de manipulerede pixels.
Frekvensdomæne & Diffusionsspor
Diffusionsmodeller efterlader matematiske fingeraftryk i højfrekvensbåndene, hvor metaldeformationer og lakrefleksioner mangler fysisk lysbrydning.
Fejlgradienter & Pixel-komprimering
Error Level Analysis (ELA) afslører mikroskopiske uoverensstemmelser i komprimeringsrater mellem det originale karrosseri og den indsatte skade.
C2PA Proveniens & Strukturdata
Kryptografisk kontrol af billedhistorik, optiske profiler og hardware-signaturer, der verificerer om billedet stammer direkte fra en kameralinse.
Skræddersyet detektion til danske nøglesektorer.
Generativ AI rammer forskellige brancher på vidt forskellige måder. AISkan tilpasser analysemodeller, dokumentation og risikotærskler til din sektors krav.
Forsikring
Syntetiske vandskader, knuste mobilskærme og bilbuler fabrikeret i AI-apps. Analyse af billeder og tekst med fokus på danske skadesscenarier.
Læs mereFinans
AI-manipulerede leverandørfakturaer, falske udlægsbilag og polerede årsrapporter, fanget før udbetaling og bogføring.
Læs mereUddannelse
Ingen black-box procentsatser i elevsamtalen. Konkrete sproglige beviser: syntetiske vendinger og lav burstiness.
Læs mereJuridisk
Validering af modpartens bilag, kontrakter og vidneforklaringer mod AI-hallucinationer, med fuld revisionslog.
Læs mereMedier
Screening af debatindlæg, pressemeddelelser og læserfotos før publicering, så troværdigheden holder.
Læs mereCybersikkerhed
Afslør spear-phishing, CEO-fraud og bot-mails skrevet i fejlfri dansk, der glider forbi traditionelle filtre.
Læs mereFuld fortrolighed. Dansk compliance og garanti.
Data forbliver krypteret og under dansk databehandleraftale. Ingen tekster eller fotos anvendes nogensinde til modeltræning.
Dansk hosting
100% GDPR-sikker og opfylder alle krav fra Datatilsynet.
Ingen modeltræning
Dine filer forbliver altid dine egne og bruges aldrig til træning.
Under 2 sekunder
Øjeblikkelig analyse og scoring af tekst og billeder.
Klare rapporter
Bevisgrundlag du kan bruge i sager og samtaler.
Byg automatisk AI-detektion ind i jeres egne systemer
Automatisk scanning via REST API
Understøtter asynkrone webhooks, multipart filuploads og granulære API-nøgler. Integrér direkte i jeres skadesystemer, CMS eller læringsplatforme.
curl -X POST "https://aiskan.dk/api/scan/text" \
  -H "Authorization: Bearer aiskan_sec_..." \
  -H "Content-Type: application/json" \
-d '{"text": "Teksten her..."}'Hvad ledere og fagfolk spørger os om
Hvorfor virker internationale AI-detektorer dårligt på dansk?
De fleste amerikanske detektorer (f.eks. Turnitin eller standard perplexity-værktøjer) er udelukkende trænet på engelsk grammatik. På dansk producerer de alt for mange falske anklager. AISkan er bygget specifikt til det danske sprog og genkender de unikke syntaktiske mønstre, som LLM'er udviser, når de oversætter og formulerer sig på dansk — herunder unaturlig sætningsrytme og forudsigelige bindeord.
Hvad er risikoen for falske positiver (uskyldige der anklages)?
Vores falsk-positiv-rate er under 1 ud af 5.000 dokumenter. I stedet for blot at spytte et isoleret procenttal ud, giver AISkan jer den rå bevisbyrde: nøjagtig sætningsanalyse, sproglig klicheidentifikation og tekniske kameradata bag billeder. Det sikrer, at I altid har en saglig og juridisk holdbar dokumentation ved elevsamtaler eller svigafvisninger.
Bliver vores kunders eller elevers data brugt til at træne AI?
Nej, absolut aldrig. Al data behandles i et lukket EU-miljø med fuld kryptering. Vi tilbyder standardiserede databehandleraftaler (DPA) til skoler og forsikringsselskaber, der sikrer 100% overholdelse af GDPR og reglerne fra Datatilsynet.
Kan vi integrere AISkan direkte i vores egne systemer?
Ja, 100%. AISkan leveres med et komplet, lynhurtigt REST API og webhooks. I kan automatisere scanning af skadesanmeldelser i forsikringssoftware, opgaveafleveringer i læringsplatforme eller medieindhold i CMS-systemer. Se vores API-dokumentation her.